 几秒音频,克隆心仪声线
01 / 音色
复刻声音,或凭空创造
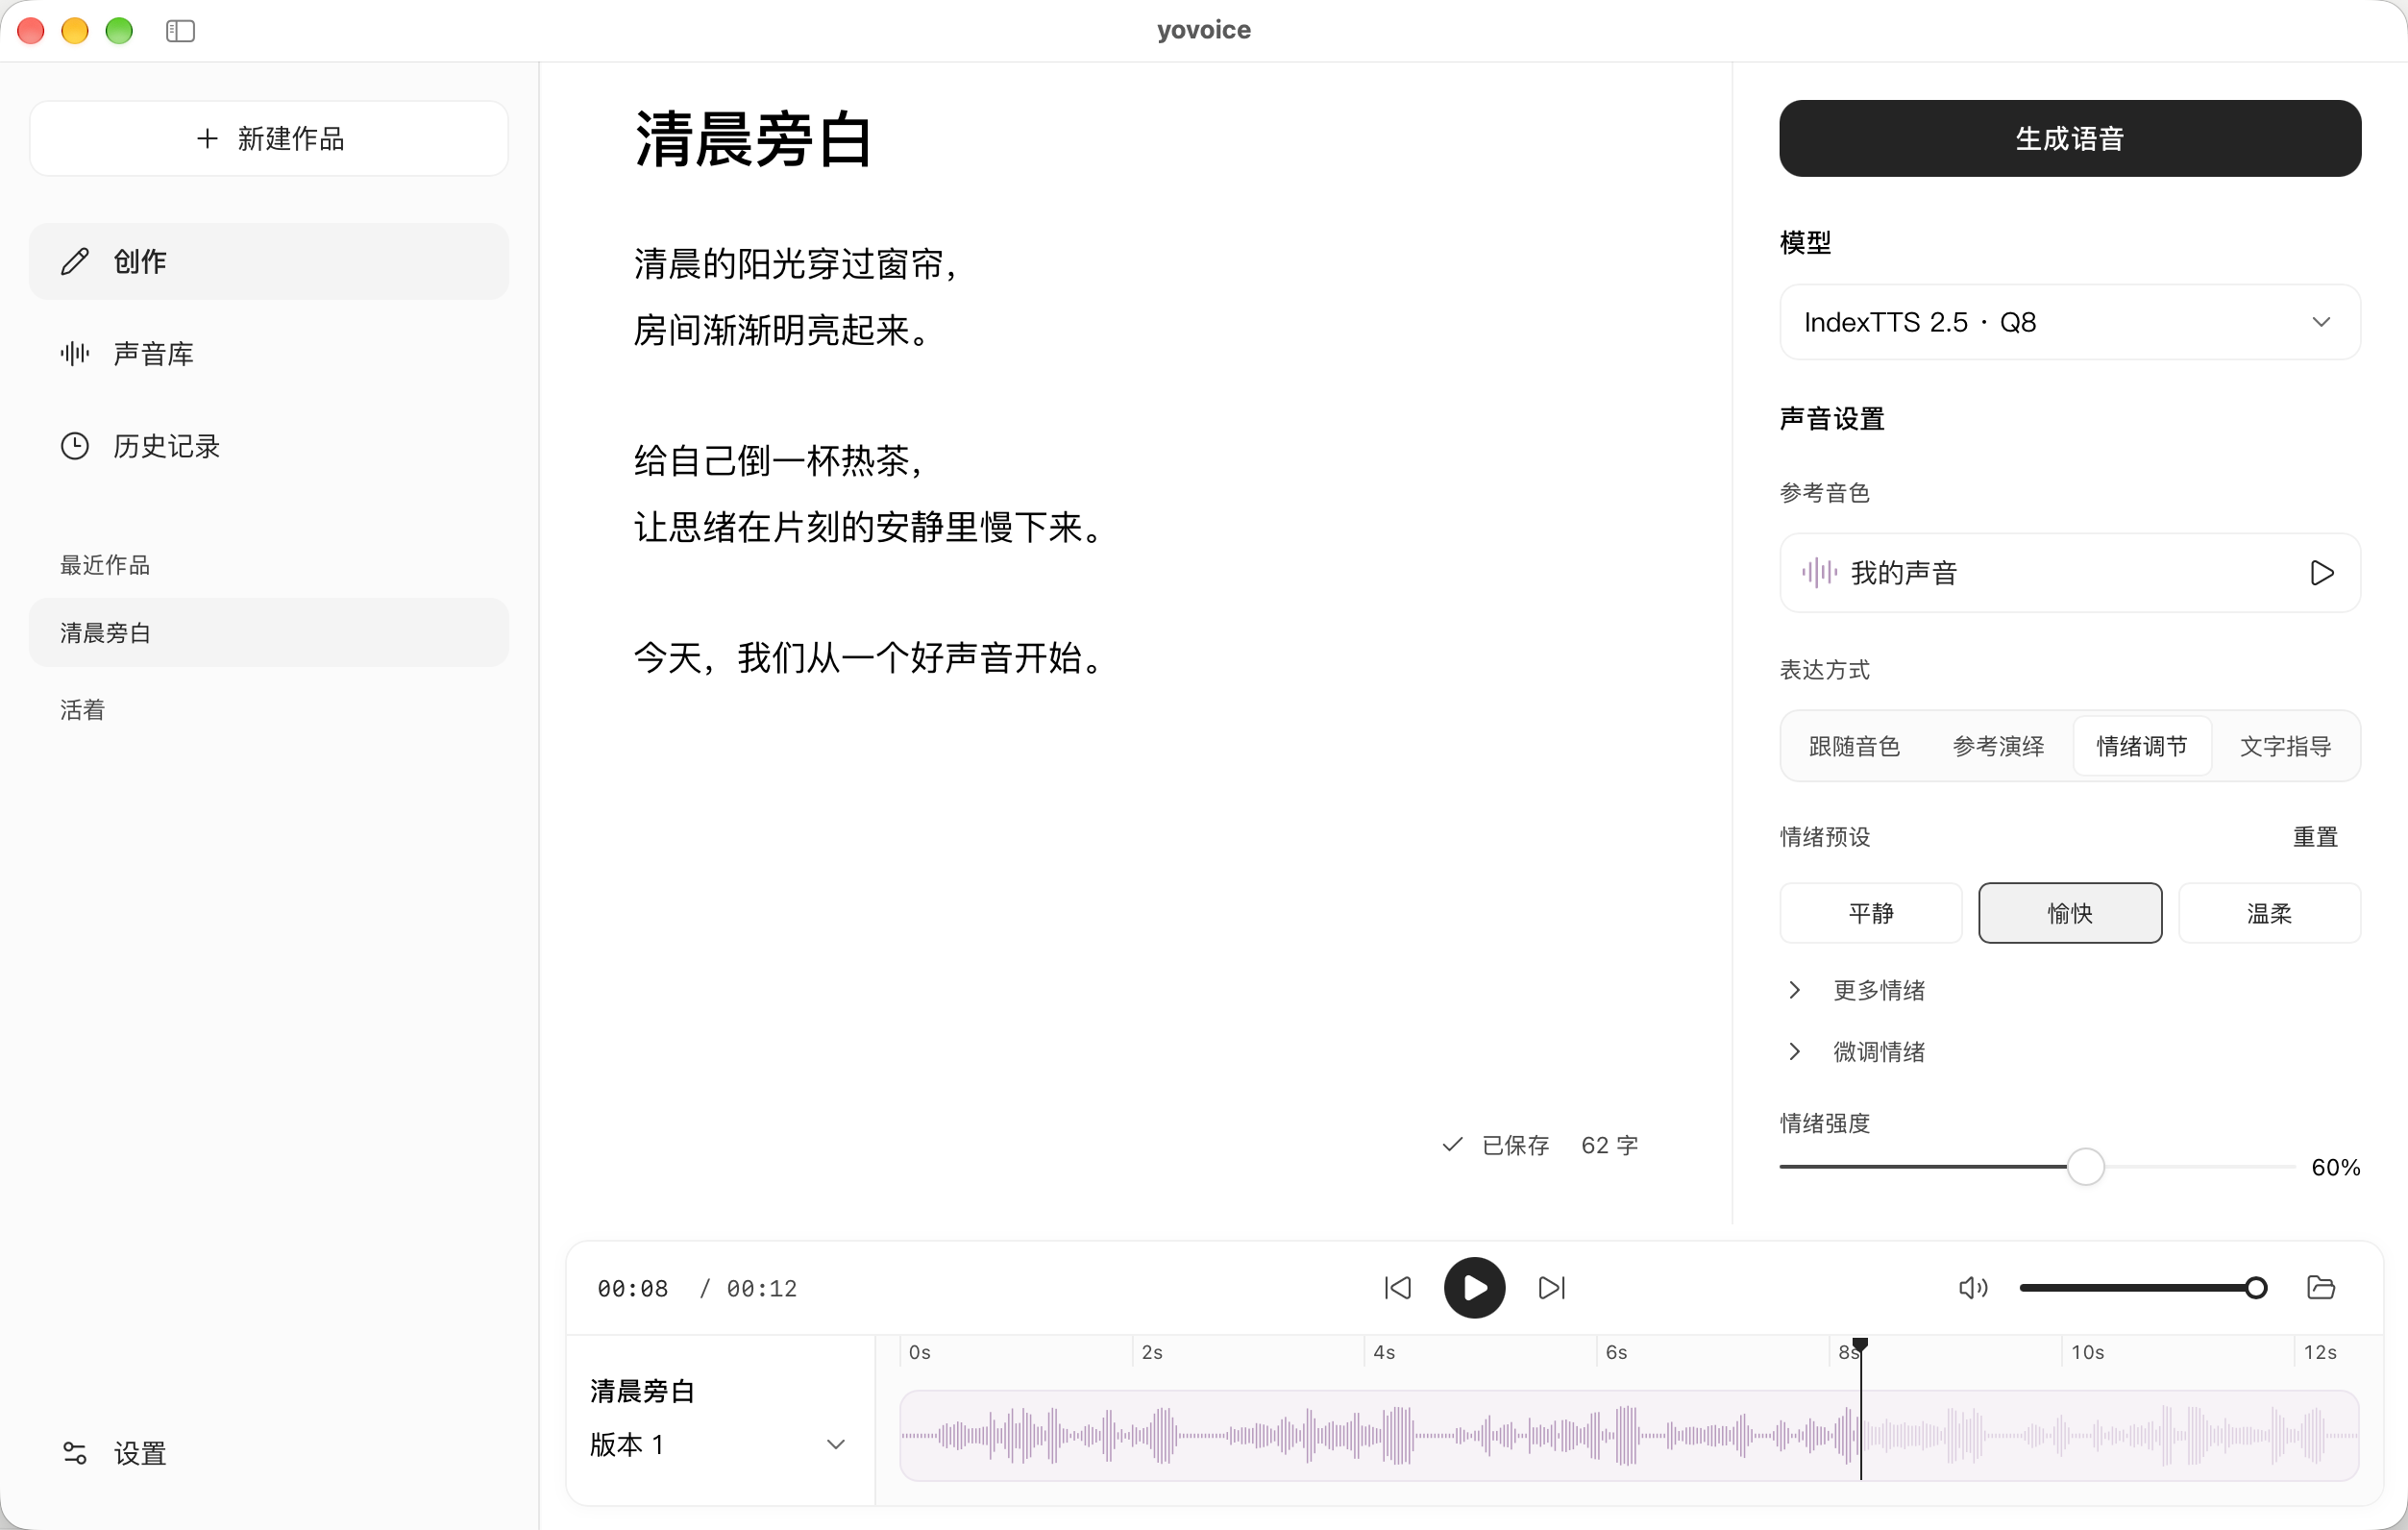
上传或录制一段参考音频,即可提取专属声线;也能直接输入文字描述,无中生有设计全新声音。
从故事配音、语音生成,到整首歌曲与多轨编曲,在自己的电脑上完成声音创作。本地运行,数据自主掌控。
他脸上黑而且瘦,已经不成样子;穿一件破夹袄,盘着两腿,下面垫一个蒲包,用草绳在肩上挂住;见了我,又说道,“温一碗酒。”掌柜也伸出头去,一面说,“孔乙己么?你还欠十九个钱呢!”孔乙己很颓唐的仰面答道,“这……下回还清罢。这一回是现钱,酒要好。”掌柜仍然同平常一样,笑着对他说,“孔乙己,你又偷了东西了!”但他这回却不十分分辩,单说了一句“不要取笑!”“取笑?要是不偷,怎么会打断腿?”孔乙己低声说道,“跌断,跌,跌……”他的眼色,很像恳求掌柜,不要再提。此时已经聚集了几个人,便和掌柜都笑了。我温了酒,端出去,放在门槛上。他从破衣袋里摸出四文大钱,放在我手里,见他满手是泥,原来他便用这手走来的。不一会,他喝完酒,便又在旁人的说笑声中,坐着用这手慢慢走去了。
左右滑动,翻阅内页 →
DEMO 随意试听
故事配音 · 语音生成 · 音乐生成 · 编曲
文本、字幕、歌词,或每个声部的音符
分配角色,选择模型或 General MIDI 音色库
保留每次生成的版本,对比后导出
 几秒音频,克隆心仪声线
上传或录制一段参考音频,即可提取专属声线;也能直接输入文字描述,无中生有设计全新声音。
你终于来了,我等你好久了。
是雀跃欢快,还是低沉克制?支持通过情绪标签、参考音频或自然语言描述调控语气,让声音传达字面之外的喜怒哀乐。
注:不同底模支持的控制粒度有所差异MUSIC / 03音乐生成演示,点击播放
根据歌词与风格描述生成完整歌曲或伴奏,也可由 Stable Audio 3 生成纯音乐与短音效,支持按谱演奏、局部重绘与逐字歌词对齐。
注:音乐生成需要支持的推理内核,部分模型需要显卡或 Apple SiliconSCORE / 04编曲演示,点击播放
直观的小节与音符编辑,多声部配器,实时试听。支持导入导出标准 MIDI,无需推理引擎,随时随地稳定渲染。
注:编曲渲染使用 General MIDI 音色库,不依赖 GPU
无需排队,无需担心隐私泄露。所有计算在本地完成,资产保存在本地目录,离线也能专注创作。
既是开箱即用的桌面应用,也是强大的脚本化工具。支持 CLI 批量处理、HTTP API 与 MCP 协议,让 AI Agent 直接调用。
| 模型 | 适用场景与核心能力 |
|---|---|
| IndexTTS 2.0 / 2.5 | 专精音色克隆与情绪控制,支持多语言克隆、参考演绎与发音调整 |
| VoxCPM2 | 文字引导的声音设计与克隆,支持参考原文辅助的精细克隆 |
| OmniVoice | 预定义属性的声音设计、克隆与非语言声音标签(笑声、叹气等) |
| Qwen3-TTS | 多语言音色克隆、9 种内置音色,以及自然语言声音设计 |
| Breeze TTS 2 | 中英自然语言设计音色、音色克隆与演绎指导;建议使用显卡 |
| Kokoro-82M 1.0 / 1.1-zh | 轻量内置音色:1.0 Official 有 49 种,1.1-zh 实验版含 100 种中文音色;支持同语言音色按比例混合 |
| ACE-Step 1.5 Turbo / XL Turbo | Turbo 根据风格描述与歌词生成歌曲或纯音乐,支持 50 多种演唱语言;XL Turbo 质量更高 |
| YuE2 3B | 根据歌词与风格生成整首带人声歌曲,长度随歌词,支持可编辑的旋律谱 |
| Stable Audio 3 | 根据英文描述生成纯音乐(最长 6 分钟)与 1–30 秒短音效,支持整体改编与局部重绘;采用 Stability AI 社区许可 |
| Ming 3.0 / XTTS v2 / Voxtral / Drama 3 | Ming 3.0 支持 7 语声音设计与克隆;XTTS v2 支持 17 语克隆;Voxtral 提供 20 种内置音色;Drama 3 支持说话人与事件标签 |
| MuseScore General / GeneralUser GS / SGM-V2.01 | 为编曲提供 General MIDI 音色渲染;无需推理引擎或显卡,结果完全确定 |
试听由 yovoice 在本地通过 CLI 生成,使用的模型标在每段声音旁。“平静”与“开心”使用相同文本和参考声线,只调整情绪参数。网页播放的是生成好的音频,不会在浏览器中运行模型。
默认存放在本机的 ~/.yovoice 目录下。你的所有文稿、音色资产和模型都在本地掌控。即使卸载客户端,这部分数据也不会被误删;如果更换电脑,直接打包备份该目录即可。
本地生成与乐谱渲染可以离线进行。安装、下载模型或音色库,以及使用可选 AI 服务时需要网络。所需文件就绪后,语音和音乐生成均在本机完成;乐谱渲染不需要推理引擎或 GPU。
可以,这项服务是可选的。接入 DeepSeek、通义千问、Kimi、OpenAI、Anthropic、Ollama 或兼容接口后,AI 可以写整份编曲,或填写歌曲风格、歌词和标题;不启用也不影响其他功能。密钥只保存在本机,请求内容会发送给你选择的服务。
当前推理内核为 audio.cpp v0.9.3,桌面版支持:
轻量朗读推荐 4GB+ 内存;高音质克隆与声音设计推荐 4–6GB 显存或 Apple Silicon 8GB+;整首歌与纯音乐生成推荐 12GB+ 显存或 Apple Silicon 16GB+。实际需求取决于模型与精度。
支持自动音频体检与专业响度标准导出:生成后自动检测爆音、咔哒声、结尾截断与长静音并在播放栏和台词旁标出,悬停可看问题详情与时间位置;导出时支持有声书(−18 LUFS)、播客(−16 LUFS)与视频平台(−14 LUFS)目标响度,真实峰值保持在 −1 dBTP 以内。
yovoice 软件本身采用 Apache-2.0 开源协议;生成内容能否商用,取决于模型许可与你对输入素材和声音拥有的权利:
当然。独立 CLI、Agent Skill 和 MCP 可以从文本与参考音色生成语音,也可以用 yovoice score render 输出混音与分轨,无需打开桌面应用。
点击图标,让 AI 读取 yovoice 的资料并回答你。
微信扫码,关注公众号