Wie wurden diese Audio-Demos erstellt?+
Die Demos wurden lokal mit yovoice über die CLI generiert, mit den jeweils angegebenen Modellen. „Ruhig“ und „Fröhlich“ nutzen denselben Text und dieselbe Referenzstimme, nur die Emotionsparameter wurden geändert. Die Website spielt fertige Dateien ab und führt keine Modelle im Browser aus.
Wo werden meine Stimmen, Projekte und Modelle gespeichert?+
Standardmäßig werden sie im lokalen Verzeichnis ~/.yovoice gespeichert. Alle Entwürfe, Stimmen und Modelle bleiben vollständig unter Ihrer lokalen Kontrolle. Eine Deinstallation löscht diese Daten nicht, und Sie können den Ordner bei einem PC-Wechsel einfach sichern.
Benötige ich eine Internetverbindung?+
Lokale Generierung und Score-Rendering funktionieren komplett offline.Netzwerk wird nur für Installation, Downloads von Modellen/Soundfonts und optionale KI-Dienste benötigt. Sobald die Dateien bereitstehen, läuft die Sprach- und Musikgenerierung lokal; Score-Rendering benötigt keine Inferenz-Engine oder GPU.
Kann KI Partituren und Songtexte für mich schreiben?+
Ja, über einen optionalen KI-Dienst.Verbinden Sie DeepSeek, Qwen, Kimi, OpenAI, Anthropic, Ollama oder kompatible Schnittstellen, um Arrangements, Stile, Texte und Titel erstellen zu lassen. Andere Funktionen bleiben ohne KI voll nutzbar. Schlüssel bleiben auf Ihrem PC.
Welche Systemanforderungen gibt es?+
Die aktuelle Inferenz-Engine ist audio.cpp v0.9.3. Die Desktop-App unterstützt:
- macOS: macOS 14 oder neuer mit Apple Silicon (M-Serie), native Metal-Beschleunigung.
- Windows: Windows 10/11 (64-Bit), mit CPU, NVIDIA CUDA und experimentellem Vulkan, inklusive CUDA 12.4 / 13.3 Installern.
- Linux: Linux x64 (Debian/Ubuntu, .deb und .tar.gz mit install.sh), integrierte CPU-Engine, optionale Vulkan GPU-Engine in den Einstellungen verfügbar.
Für einfache Vertonung genügen 4 GB+ RAM; für High-Fidelity-Klonen 4–6 GB VRAM oder 8 GB+ Apple Silicon; für ganze Songs 12 GB+ VRAM oder 16 GB+ Apple Silicon.
Wie werden Audioqualität und Lautheit beim Export gesteuert?+
Unterstützt automatische Audio-Prüfung und professionelle Lautheits-Exportstandards:Erkennt Clipping, Klicks, abgeschnittene Enden und lange Pausen nach der Generierung und markiert sie mit Zeitstempeln. Beim Export stehen Ziel-Lautheiten für Hörbücher (−18 LUFS), Podcasts (−16 LUFS) und Videos (−14 LUFS) mit True Peak unter −1 dBTP bereit.
Darf ich generierte Sprache und Musik kommerziell nutzen?+
yovoice steht unter der Apache-2.0-Lizenz. Die kommerzielle Nutzbarkeit generierter Inhalte hängt von den Modelllizenzen und Ihren Rechten am Ausgangsmaterial ab:
- Gewichte von OmniVoice (CC-BY-NC), YuE2 (CC BY-NC 4.0) und Breeze TTS 2 (BreezeBlue Forschungs- und Nicht-Kommerzielle Lizenz) sind auf nicht-kommerzielle Nutzung beschränkt; mit Breeze TTS 2 generierte Sprache ist ebenfalls nicht für die kommerzielle Nutzung lizenziert. Stable Audio 3 nutzt die Stability AI Community-Lizenz (kostenlos bei Jahresumsatz unter 1 Mio. USD). IndexTTS hat eine eigene Modell-Lizenz.
- Prüfen Sie die Bedingungen der Modellherausgeber. Stellen Sie vor der kommerziellen Nutzung sicher, dass Sie die erforderlichen Rechte am Referenzmaterial besitzen.
Kann ein KI-Agent Sprache generieren oder Scores über yovoice rendern?+
Ja. Die eigenständige CLI, der Agent Skill und MCP können Sprache generieren oder mit `yovoice score render` Mischungen und Stems ausgeben, ohne die Desktop-App zu öffnen.
Agent Skill ansehen
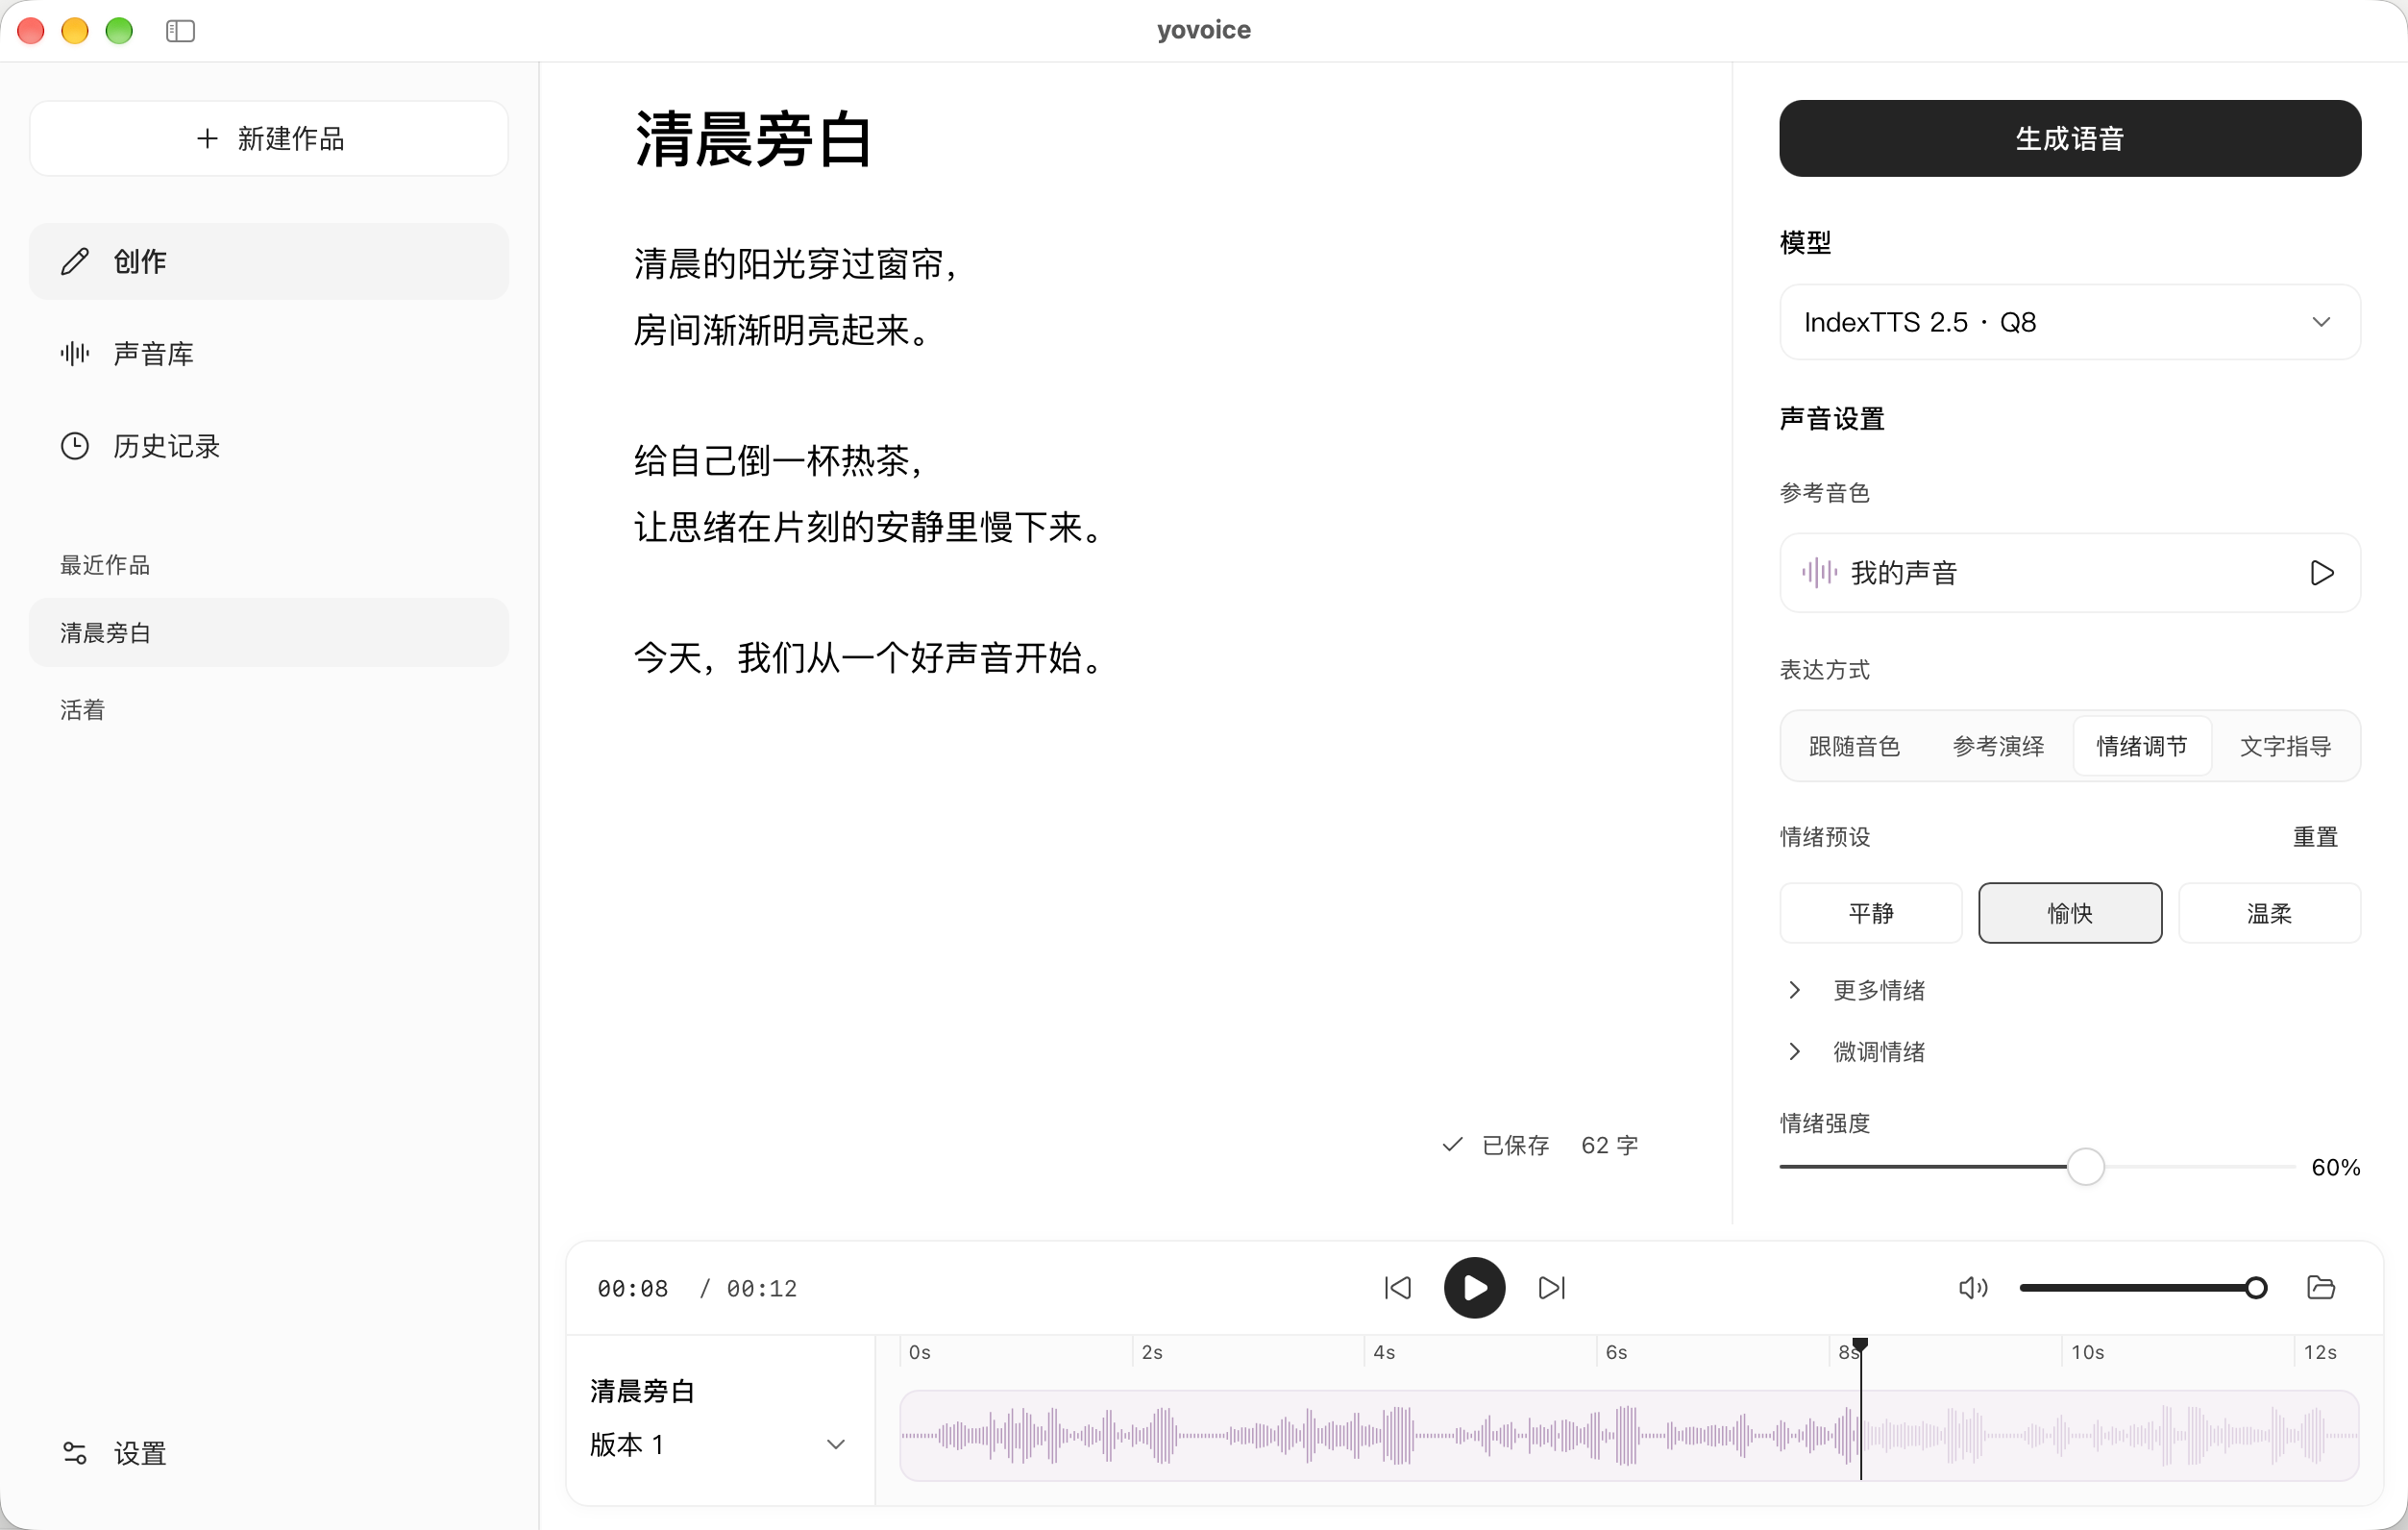
 Wenige Sekunden Audio zum Klonen einer Stimme