 幾秒音訊,複製心儀聲線
01 / 音色
復刻聲音,或憑空創造
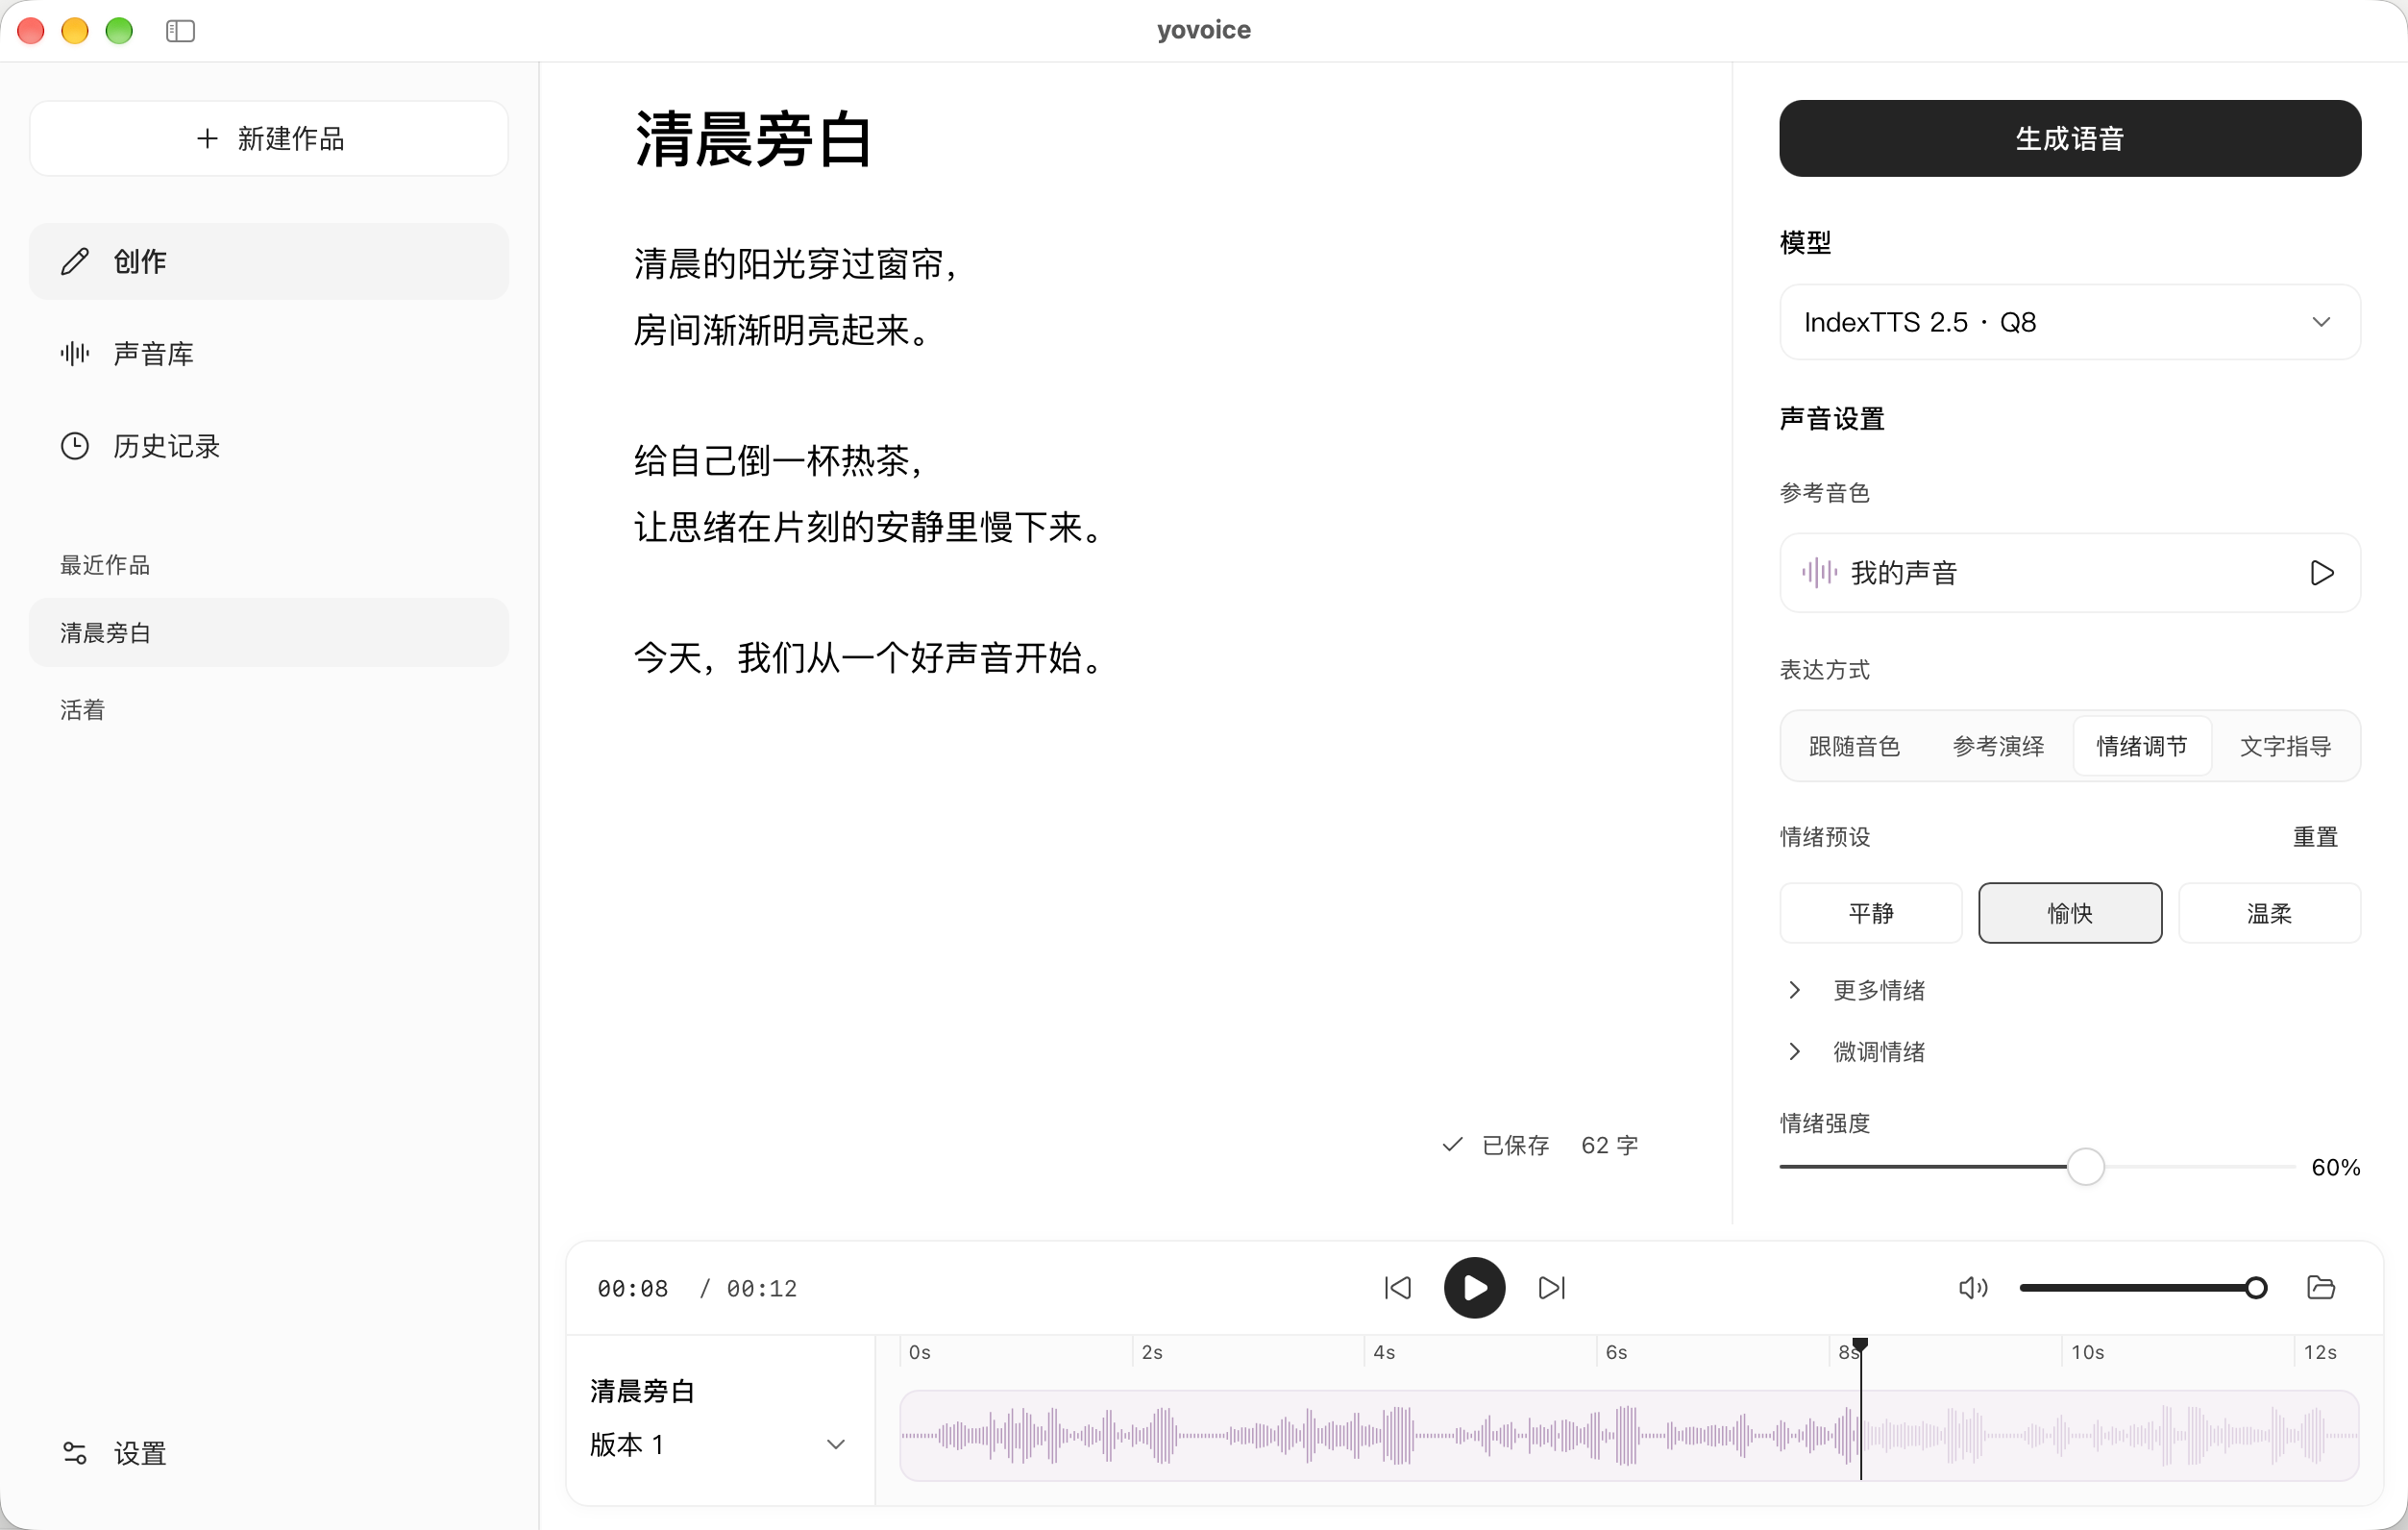
上傳或錄製一段參考音訊,即可提取專屬聲線;亦能直接輸入文字描述,無中生有設計全新聲音。
從故事配音、語音生成,到整首歌曲與多軌編曲,在自己的電腦上完成聲音創作。本機運行,數據自主掌控。
他脸上黑而且瘦,已经不成样子;穿一件破夹袄,盘着两腿,下面垫一个蒲包,用草绳在肩上挂住;见了我,又说道,“温一碗酒。”掌柜也伸出头去,一面说,“孔乙己么?你还欠十九个钱呢!”孔乙己很颓唐的仰面答道,“这……下回还清罢。这一回是现钱,酒要好。”掌柜仍然同平常一样,笑着对他说,“孔乙己,你又偷了东西了!”但他这回却不十分分辩,单说了一句“不要取笑!”“取笑?要是不偷,怎么会打断腿?”孔乙己低声说道,“跌断,跌,跌……”他的眼色,很像恳求掌柜,不要再提。此时已经聚集了几个人,便和掌柜都笑了。我温了酒,端出去,放在门槛上。他从破衣袋里摸出四文大钱,放在我手里,见他满手是泥,原来他便用这手走来的。不一会,他喝完酒,便又在旁人的说笑声中,坐着用这手慢慢走去了。
左右滑動,翻閱內頁 →
DEMO 隨意試聽
故事配音 · 語音生成 · 音樂生成 · 編曲
文字、字幕、歌詞,或每個聲部的音符
分配角色,選擇模型或 General MIDI 音色庫
保留每次生成的版本,對比後匯出
 幾秒音訊,複製心儀聲線
上傳或錄製一段參考音訊,即可提取專屬聲線;亦能直接輸入文字描述,無中生有設計全新聲音。
你终于来了,我等你好久了。
是雀躍歡快,還是低沉克制?支援透過情緒標籤、參考音訊或自然語言描述調控語氣,讓聲音傳達字面之外的喜怒哀樂。
註:不同基底模型支援的控制細緻度有所不同MUSIC / 03音樂生成示範,點擊播放
根據歌詞與風格描述生成完整歌曲或伴奏,也可由 Stable Audio 3 生成純音樂與短音效,支援按譜演奏、局部重繪與逐字歌詞對齊。
註:音樂生成需要支援的推論核心,部分模型需要顯示卡或 Apple SiliconSCORE / 04編曲示範,點擊播放
直觀的小節與音符編輯,多聲部配器,實時試聽。支援匯入匯出標準 MIDI,無需推論核心,隨時隨地穩定渲染。
註:編曲渲染使用 General MIDI 音色庫,不依賴 GPU
無需排隊,無需擔心私隱洩漏。所有計算在本機完成,資產保存在本機目錄,離線也能專注創作。
既是開箱即用的桌面應用,也是強大的腳本化工具。支援 CLI 批量處理、HTTP API 與 MCP 協議,讓 AI Agent 直接調用。
| 模型 | 適用場景與核心能力 |
|---|---|
| IndexTTS 2.0 / 2.5 | 專精音色複製與情緒控制,支援多語言複製、參考演繹與發音調整 |
| VoxCPM2 | 文字引導的聲音設計與複製,支援參考原文輔助的精細複製 |
| OmniVoice | 預定義屬性的聲音設計、複製與非語言聲音標籤(笑聲、嘆氣等) |
| Qwen3-TTS | 多語言音色複製、9 種內建音色,以及自然語言聲音設計 |
| Breeze TTS 2 | 中英自然語言設計音色、音色複製與演繹指導;建議使用顯示卡 |
| Kokoro-82M 1.0 / 1.1-zh | 輕量內建音色:1.0 Official 有 49 種,1.1-zh 實驗版含 100 種中文音色;支援同語言音色按比例混合 |
| ACE-Step 1.5 Turbo / XL Turbo | Turbo 根據風格描述與歌詞生成歌曲或純音樂,支援 50 多種演唱語言;XL Turbo 品質更高 |
| YuE2 3B | 根據歌詞與風格生成整首帶人聲歌曲,長度隨歌詞,支援可編輯的旋律譜 |
| Stable Audio 3 | 根據英文描述生成純音樂(最長 6 分鐘)與 1–30 秒短音效,支援整體改編與局部重繪;採用 Stability AI 社群授權 |
| Ming 3.0 / XTTS v2 / Voxtral / Drama 3 | Ming 3.0 支援 7 種語言聲音設計與複製;XTTS v2 支援 17 種語言複製;Voxtral 提供 20 種內建音色;Drama 3 支援說話者與事件標籤 |
| MuseScore General / GeneralUser GS / SGM-V2.01 | 為編曲提供 General MIDI 音色渲染;無需推論核心或顯示卡,結果完全確定 |
試聽由 yovoice 在本機透過 CLI 生成,使用的模型標在每段聲音旁。「平靜」與「開心」使用相同文字和參考聲線,只調整情緒參數。網頁播放的是生成好的音訊,不會在瀏覽器中運行模型。
預設存放在本機的 ~/.yovoice 目錄下。你的所有文稿、音色資產和模型都在本機掌控。即使解除安裝客戶端,這部分資料也不會被誤刪;如果更換電腦,直接打包備份該目錄即可。
本機生成與樂譜渲染可以離線進行。安裝、下載模型或音色庫,以及使用可選 AI 服務時需要網絡。所需檔案就緒後,語音和音樂生成均在本機完成;樂譜渲染不需要推論核心或 GPU。
可以,這項服務是可選的。接入 DeepSeek、通義千問、Kimi、OpenAI、Anthropic、Ollama 或相容介面後,AI 可以編寫整份編曲,或填寫歌曲風格、歌詞和標題;不啟用亦不影響其他功能。密鑰只保存在本機,請求內容會發送給你選擇的服務。
目前推論核心為 audio.cpp v0.9.3,桌面版支援:
輕量朗讀推薦 4GB+ 記憶體;高音質複製與聲音設計推薦 4–6GB 顯示卡記憶體或 Apple Silicon 8GB+;整首歌與純音樂生成推薦 12GB+ 顯示卡記憶體或 Apple Silicon 16GB+。實際需求取決於模型與精度。
支援自動音訊體檢與專業響度標準匯出:生成後自動檢測爆音、喀噠聲、結尾截斷與長靜音並在播放欄和台詞旁標出,懸停可看問題詳情與時間位置;匯出時支援有聲書(−18 LUFS)、播客(−16 LUFS)與視訊平台(−14 LUFS)目標響度,真實峰值保持在 −1 dBTP 以內。
yovoice 軟體本身採用 Apache-2.0 開源協議;生成內容能否商用,取決於模型授權與你對輸入素材和聲音擁有的權利:
當然。獨立 CLI、Agent Skill 和 MCP 可以從文字與參考音色生成語音,也可以用 yovoice score render 輸出混音與分軌,無需打開桌面應用。
點擊圖標,讓 AI 讀取 yovoice 的資料並回答你。
微信掃碼,關注公眾號