 단 몇 초의 오디오로 마음에 드는 음성 복제
01 / 음색
목소리를 복제하거나, 새롭게 창조하거나
참조 오디오를 업로드하거나 녹음하여 고유한 음색을 추출하고, 텍스트 묘사만으로 세상에 없던 새로운 목소리를 만들어낼 수도 있습니다.
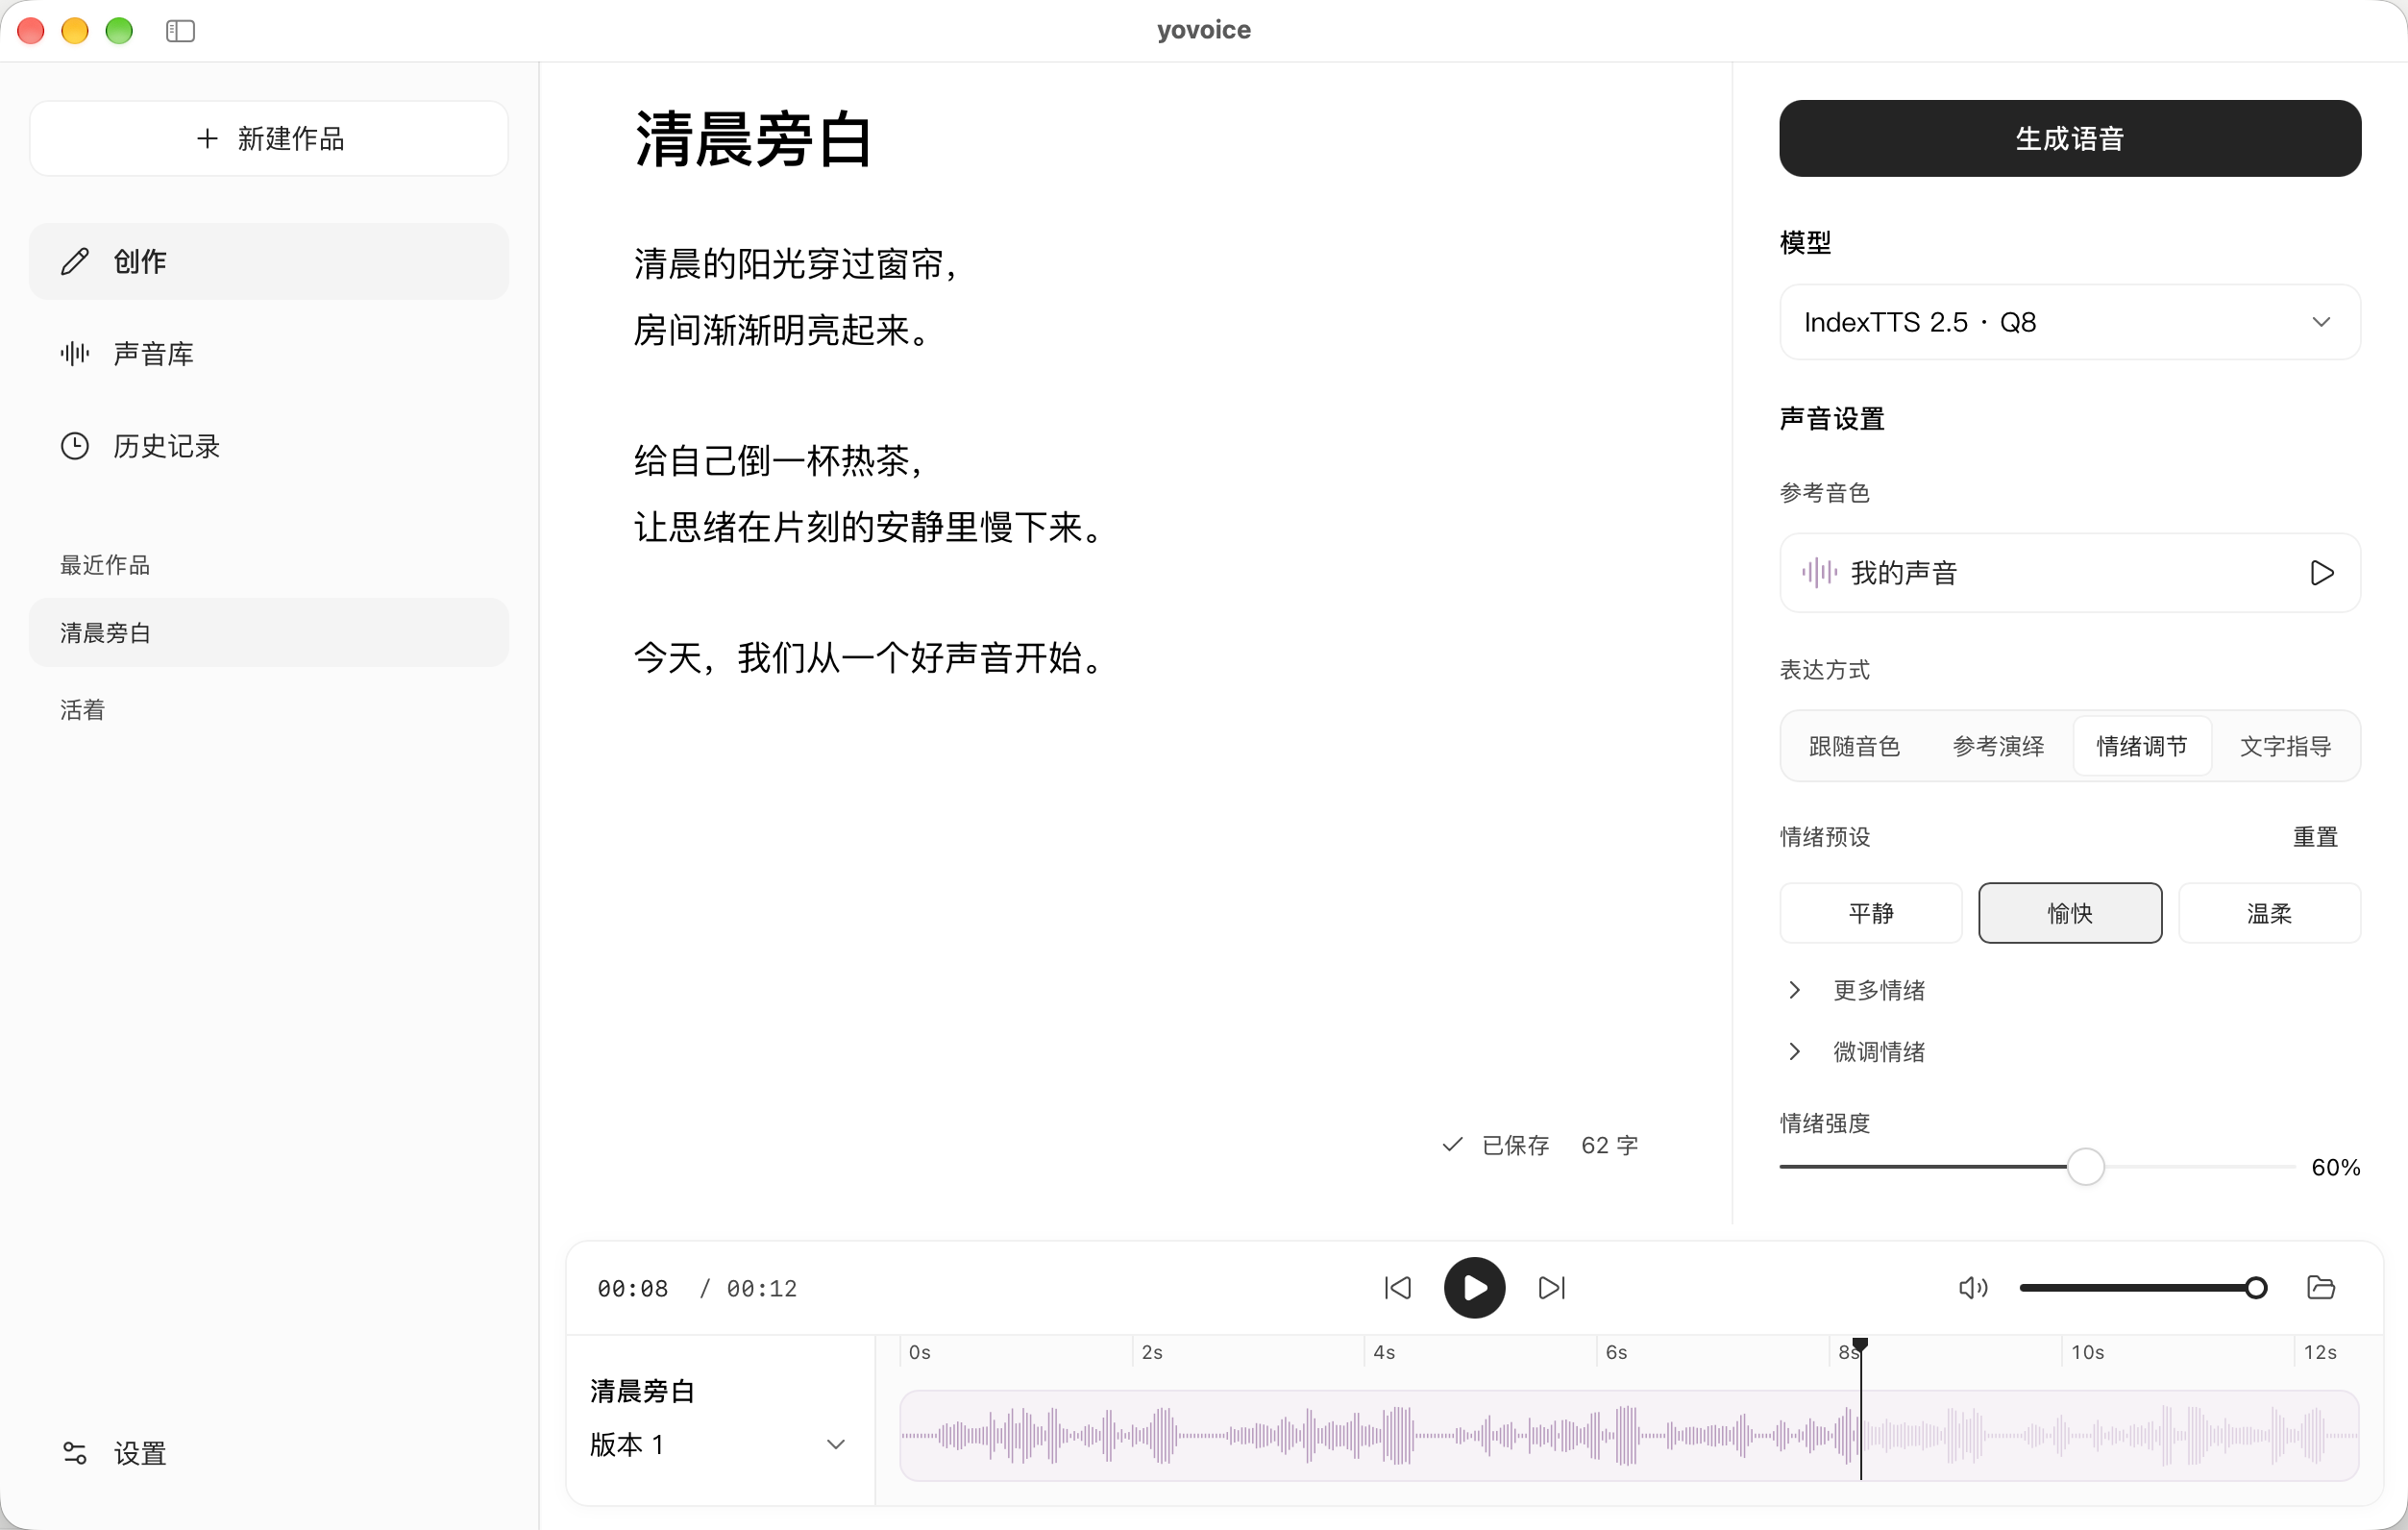
스토리 더빙과 음성 생성부터 완곡 및 멀티트랙 편곡까지, 내 컴퓨터에서 오디오를 창작하세요. 로컬에서 실행되며 데이터를 직접 관리합니다.
他脸上黑而且瘦,已经不成样子;穿一件破夹袄,盘着两腿,下面垫一个蒲包,用草绳在肩上挂住;见了我,又说道,“温一碗酒。”掌柜也伸出头去,一面说,“孔乙己么?你还欠十九个钱呢!”孔乙己很颓唐的仰面答道,“这……下回还清罢。这一回是现钱,酒要好。”掌柜仍然同平常一样,笑着对他说,“孔乙己,你又偷了东西了!”但他这回却不十分分辩,单说了一句“不要取笑!”“取笑?要是不偷,怎么会打断腿?”孔乙己低声说道,“跌断,跌,跌……”他的眼色,很像恳求掌柜,不要再提。此时已经聚集了几个人,便和掌柜都笑了。我温了酒,端出去,放在门槛上。他从破衣袋里摸出四文大钱,放在我手里,见他满手是泥,原来他便用这手走来的。不一会,他喝完酒,便又在旁人的说笑声中,坐着用这手慢慢走去了。
좌우로 스와이프하여 라이너 노트 보기 →
DEMO 자유롭게 들어보세요
스토리 더빙 · 음성 생성 · 음악 생성 · 편곡
텍스트, 자막, 가사 또는 각 트랙의 음표
캐릭터 배정, 모델 또는 General MIDI 사운드폰트 선택
모든 생성 버전을 보관하고 비교한 후 내보내기
 단 몇 초의 오디오로 마음에 드는 음성 복제
참조 오디오를 업로드하거나 녹음하여 고유한 음색을 추출하고, 텍스트 묘사만으로 세상에 없던 새로운 목소리를 만들어낼 수도 있습니다.
你终于来了,我等你好久了。
밝고 경쾌한 톤부터 차분하고 절제된 톤까지, 감정 태그, 참조 오디오, 자연어 설명으로 어조를 조절하여 말 이상의 감정을 표현하세요.
참고: 제어 가능한 세부 항목은 모델에 따라 다릅니다MUSIC / 03음악 생성 데모 (소리 포함, 클릭하여 재생)
가사와 스타일 묘사로 완곡 또는 반주를 생성하고, Stable Audio 3로 순수 연주곡 및 효과음을 제작하며, 악보 기반 연주, 부분 인페인팅 및 한 글자 단위 가사 동기화를 지원합니다.
참고: 음악 생성에는 지원되는 추론 엔진이 필요하며, 일부 모델은 외장 그래픽 또는 Apple Silicon을 필요로 합니다SCORE / 04편곡 데모 (소리 포함, 클릭하여 재생)
직관적인 마디와 음표 편집, 다성부 악기 편성, 실시간 미리듣기. 표준 MIDI 파일의 가져오기 및 내보내기를 지원하며, 추론 엔진 없이 언제 어디서나 안정적으로 렌더링합니다.
참고: 편곡 렌더링은 General MIDI 사운드폰트를 사용하며 GPU에 의존하지 않습니다
대기열도, 개인정보 유출 걱정도 없습니다. 모든 연산이 로컬에서 처리되고 자산이 컴퓨터에 저장되어 오프라인에서도 창작에만 몰입할 수 있습니다.
설치 즉시 사용 가능한 데스크톱 앱이자 강력한 스크립트 도구입니다. CLI 배치 처리, HTTP API, MCP 프로토콜을 지원하여 AI Agent와 손쉽게 연동할 수 있습니다.
| 모델 | 주요 활용 시나리오 및 핵심 역량 |
|---|---|
| IndexTTS 2.0 / 2.5 | 음성 복제 및 감정 제어 특화: 다국어 복제, 참조 연기 및 발음 교정 지원 |
| VoxCPM2 | 텍스트 기반 음성 디자인 및 복제, 참조 원문 기반의 정밀 복제 지원 |
| OmniVoice | 사전 정의된 속성 기반 음성 디자인, 복제 및 비언어적 사운드 태그 (웃음, 한숨 등) 지원 |
| Qwen3-TTS | 다국어 음성 복제, 9가지 내장 음성 스타일 제어 및 자연어 음성 디자인 |
| Breeze TTS 2 | 중국어 및 영어 자연어 음성 디자인, 복제 및 연기 가이드 지원; GPU 권장 |
| Kokoro-82M 1.0 / 1.1-zh | 가벼운 내장 음색: 1.0 Official 49종, 실험판 1.1-zh 중국어 100종 내장, 동일 언어 간 음성 비율 혼합 지원 |
| ACE-Step 1.5 Turbo / XL Turbo | Turbo는 스타일 설명과 가사로 노래나 연주곡을 생성하며 50개 이상의 가창 언어를 지원합니다. XL Turbo는 한층 높은 음질 제공 |
| YuE2 3B | 가사와 스타일로 보컬 완곡 생성, 가사 길이에 맞춰 곡 길이 결정, 편집 가능한 멜로디 악보 지원 |
| Stable Audio 3 | 영어 설명으로 순수 연주 음악(최대 6분) 및 1~30초 효과음 생성, 전체 편곡 및 부분 인페인팅 지원, Stability AI 커뮤니티 라이선스 |
| Ming 3.0 / XTTS v2 / Voxtral / Drama 3 | Ming 3.0은 7개 언어 음성 디자인 및 복제 지원, XTTS v2는 17개 언어 복제 지원, Voxtral은 20개 내장 음성 제공, Drama 3은 화자 및 이벤트 태그 지원 |
| MuseScore General / GeneralUser GS / SGM-V2.01 | 편곡을 위한 General MIDI 사운드폰트 렌더링; 추론 엔진이나 외장 GPU 불필요, 완벽하게 결정론적 결과 제공 |
샘플은 각 클립 옆에 표기된 모델을 사용하여 로컬 CLI로 yovoice에서 생성되었습니다. '차분함'과 '기쁨'은 동일한 텍스트와 참조 음성을 사용하고 감정 파라미터만 조정했습니다. 웹페이지는 미리 렌더링된 오디오를 재생하며 브라우저에서 모델을 실행하지 않습니다.
기본적으로 컴퓨터의 ~/.yovoice 디렉터리에 저장됩니다. 모든 원고, 음성 자산, 모델을 로컬에서 안전하게 직접 관리할 수 있습니다. 앱을 삭제해도 데이터는 유지되며, 컴퓨터를 바꿀 때 해당 디렉터리를 백업하여 옮기기만 하면 됩니다.
로컬 음성 생성과 악보 렌더링은 오프라인에서도 완벽하게 동작합니다.설치, 모델 및 사운드폰트 다운로드, 그리고 선택적 AI 서비스를 이용할 때만 인터넷이 필요합니다. 필수 파일이 준비되면 음성 및 음악 생성은 전적으로 로컬에서 처리되며, 악보 렌더링은 추론 엔진이나 외장 GPU조차 필요하지 않습니다.
네, 선택적 AI 연동을 통해 가능합니다.DeepSeek, Qwen, Kimi, OpenAI, Anthropic, Ollama 또는 호환 API를 연결하면 AI가 전체 편곡을 작성하거나 곡 스타일, 가사, 제목을 채워줄 수 있습니다. 사용하지 않아도 다른 기능에는 영향이 없습니다. API 키는 로컬에만 저장되며 요청은 선택한 서비스로만 전송됩니다.
현재 추론 엔진은 audio.cpp v0.9.3이며, 데스크톱 버전은 다음을 지원합니다:
가벼운 낭독에는 4GB 이상의 RAM, 고음질 복제 및 음성 디자인에는 4~6GB VRAM 또는 Apple Silicon 8GB 이상, 완곡 및 연주곡 생성에는 12GB 이상 VRAM 또는 Apple Silicon 16GB 이상을 권장합니다. 실제 요구 사양은 모델 및 정밀도에 따라 다릅니다.
자동 오디오 검진 및 표준 음량 내보내기를 지원합니다:생성 후 클리핑, 클릭 노이즈, 말끝 끊김, 장시간 묵음을 자동으로 감지하여 플레이어 및 타임라인에 시간대와 세부 정보를 표시합니다. 내보내기 시 오디오북(-18 LUFS), 팟캐스트(-16 LUFS), 동영상 플랫폼(-14 LUFS) 표준 목표 음량을 제공하며 트루 피크는 -1 dBTP 이내로 유지됩니다.
yovoice 소프트웨어 자체는 Apache-2.0 오픈소스 라이선스를 따릅니다. 생성물의 상업적 이용 가능 여부는 각 모델 라이선스 및 입력 자료에 대한 사용 권리에 달려 있습니다:
물론입니다.독립형 CLI, Agent Skill, MCP 연동을 통해 데스크톱 앱을 열지 않고도 텍스트와 참조 음성으로 음성을 생성하거나 `yovoice score render`로 믹싱 및 개별 트랙(Stem)을 출력할 수 있습니다.
 yovoice DESKTOP APPLICATION
로컬 음성 및 음악 · 버전 비교 · 자동 오디오 검진 · 표준 음량 내보내기
아이콘을 클릭하여 AI가 yovoice 문서를 읽고 답변하도록 하세요.
WeChat으로 QR 코드를 스캔하여 팔로우하세요