 わずか数秒の音声で、理想の声を再現
01 / 声の質感
声を再現する、あるいはゼロから創る
数秒のリファレンス音声を録音・アップロードして音色を抽出。テキストで特徴を記述し、全く新しい声をゼロからデザインすることも可能です。
ストーリーの吹き替えから音声合成、フル楽曲、多軌道での編曲まで、すべてローカルPC上で完結。データは手元で安全に管理できます。
他脸上黑而且瘦,已经不成样子;穿一件破夹袄,盘着两腿,下面垫一个蒲包,用草绳在肩上挂住;见了我,又说道,“温一碗酒。”掌柜也伸出头去,一面说,“孔乙己么?你还欠十九个钱呢!”孔乙己很颓唐的仰面答道,“这……下回还清罢。这一回是现钱,酒要好。”掌柜仍然同平常一样,笑着对他说,“孔乙己,你又偷了东西了!”但他这回却不十分分辩,单说了一句“不要取笑!”“取笑?要是不偷,怎么会打断腿?”孔乙己低声说道,“跌断,跌,跌……”他的眼色,很像恳求掌柜,不要再提。此时已经聚集了几个人,便和掌柜都笑了。我温了酒,端出去,放在门槛上。他从破衣袋里摸出四文大钱,放在我手里,见他满手是泥,原来他便用这手走来的。不一会,他喝完酒,便又在旁人的说笑声中,坐着用这手慢慢走去了。
スワイプでブックレットをめくる →
DEMO ご自由に試聴ください
ストーリー吹き替え · 音声生成 · 音楽生成 · 編曲
原稿、字幕、歌詞、各トラックの音符まで
登場人物に音声を割り当て、モデルやGeneral MIDI音源を選択
テイクごとにバージョンを保存、比較してエクスポート
 わずか数秒の音声で、理想の声を再現
数秒のリファレンス音声を録音・アップロードして音色を抽出。テキストで特徴を記述し、全く新しい声をゼロからデザインすることも可能です。
你终于来了,我等你好久了。
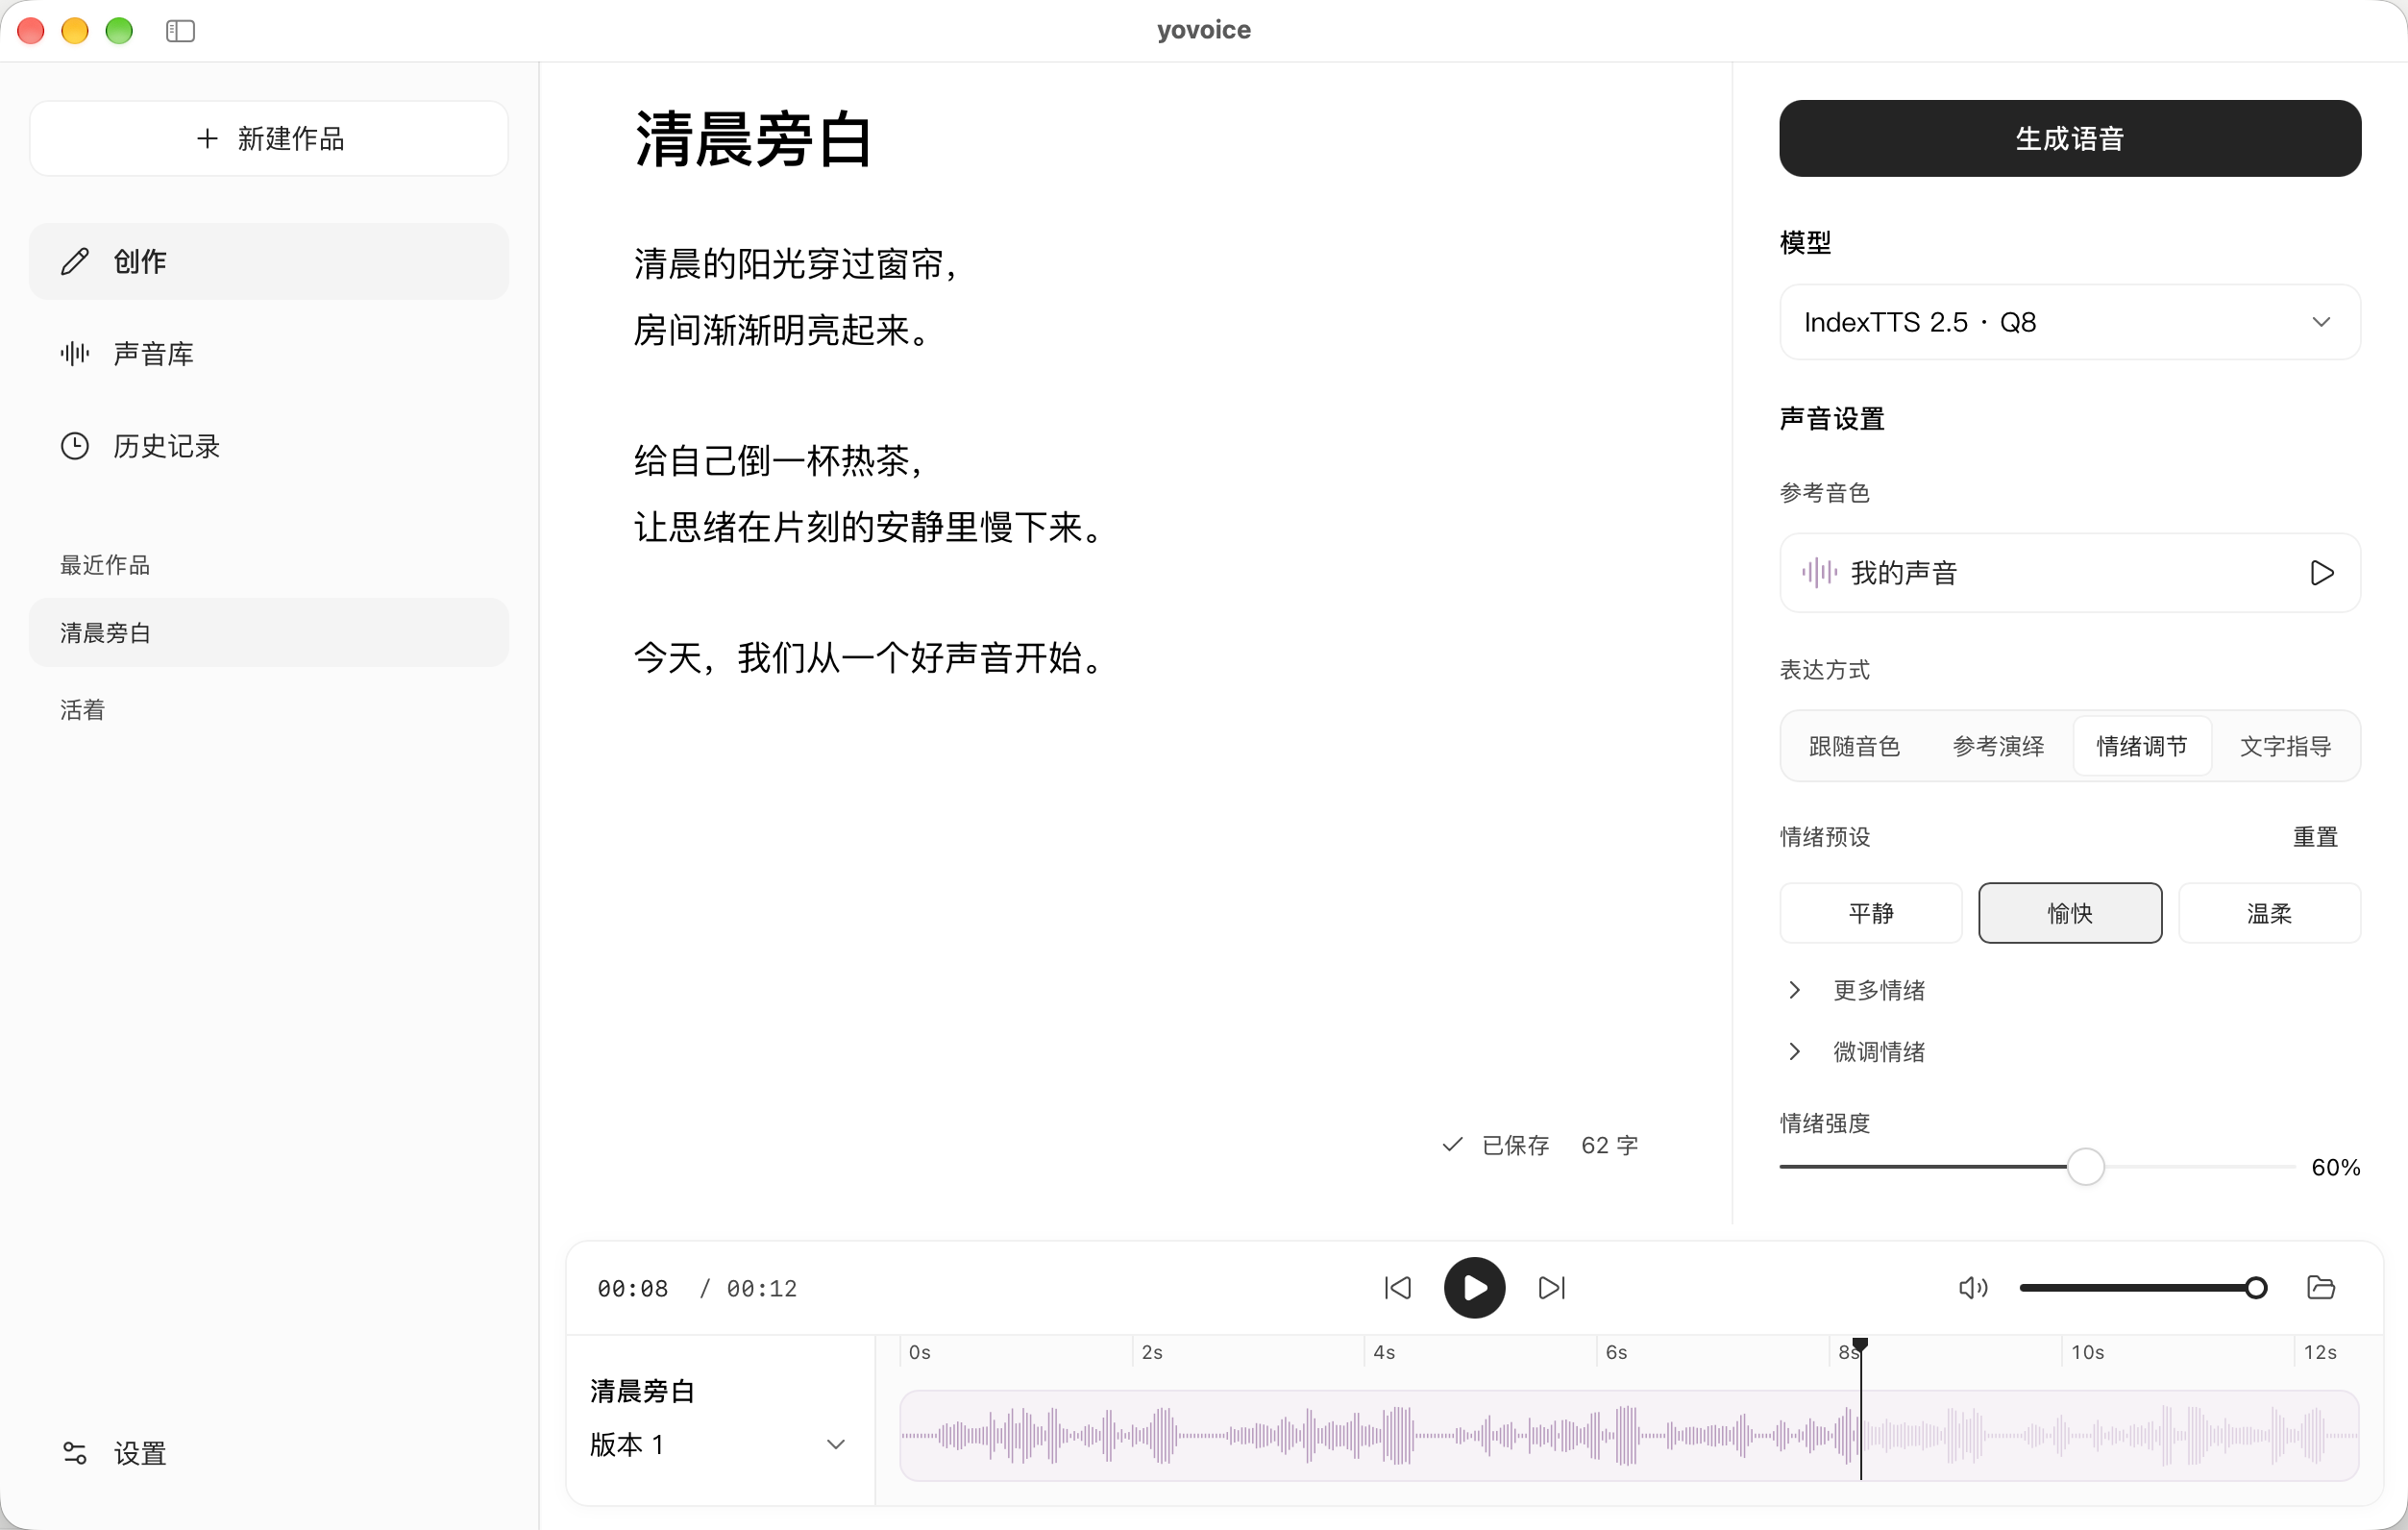
弾むような歓びから、静かで抑えの利いた語りまで。感情タグやリファレンス音声、自然言語プロンプトで抑揚を自在にコントロールできます。
※モデルによって対応する調整項目や精度が異なりますMUSIC / 03音楽生成デモ(音声あり・クリックして再生)
歌詞とスタイルの説明からフル楽曲や伴奏を生成。Stable Audio 3によるインスト音楽や効果音の生成、楽譜からの演奏、部分インペイント、逐字歌詞同期にも対応。
※音楽生成には対応する推論エンジンが必要です。一部のモデルはGPUまたはApple Siliconを推奨しますSCORE / 04編曲デモ(音声あり・クリックして再生)
小節と音符の直感的なエディタ、マルチパートの楽器編成、リアルタイム試聴。標準MIDIの入出力に対応し、推論エンジン不要でいつでも高速・忠実にレンダリング。
※楽譜レンダリングにはGeneral MIDIサウンドフォントを使用し、GPUに依存しません
待ち時間も、プライバシーの心配もありません。計算はすべてローカルで実行され、素材も手元のフォルダに保存。オフラインでも創作に集中できます。
手軽に使えるデスクトップアプリでありながら、強力なスクリプトツールでもあります。CLIバッチ処理、HTTP API、MCPプロトコルに対応し、AI Agentと直接連携可能です。
| モデル | 主な用途と中核機能 |
|---|---|
| IndexTTS 2.0 / 2.5 | 音声複製と感情制御に特化。多言語クローン、リファレンス演技、発音の微調整に対応 |
| VoxCPM2 | テキストによる声の設計と複製に対応。リファレンス原稿を用いた精密クローンも可能 |
| OmniVoice | 事前定義された属性による声の設計、複製、および非言語音声タグ(笑い声、ため息など) |
| Qwen3-TTS | 多言語音声複製、9種の内蔵プリセット音声、および自然言語による声のデザイン |
| Breeze TTS 2 | 中国語と英語の自然言語による声の設計、複製、演出指導に対応。GPU推奨 |
| Kokoro-82M 1.0 / 1.1-zh | 軽量な内蔵プリセット音声:1.0 Officialに49種、実験版1.1-zhに100種の中国語音声。同言語音声のブレンドに対応 |
| ACE-Step 1.5 Turbo / XL Turbo | Turboはスタイル説明と歌詞から楽曲や伴奏を生成し、50以上の言語に対応。XL Turboでさらに高音質に |
| YuE2 3B | 歌詞とスタイルからボーカル付きフル楽曲を生成。長さは歌詞に連動し、編集可能なメロディ譜にも対応 |
| Stable Audio 3 | 英語の説明文からインストゥルメンタル音楽(最長6分)や1〜30秒の効果音を生成。リワークや部分インペイントに対応。Stability AIコミュニティライセンス |
| Ming 3.0 / XTTS v2 / Voxtral / Drama 3 | Ming 3.0は7言語の声設計と複製、XTTS v2は17言語の複製に対応。Voxtralは20種類の内蔵音声、Drama 3は話者・イベントタグに対応 |
| MuseScore General / GeneralUser GS / SGM-V2.01 | 編曲プロジェクト用のGeneral MIDI音源レンダリング。推論エンジンやGPU不要で、完全に同一の結果を再現 |
試聴サンプルは、各クリップ横に記載されたモデルを使用し、ローカル環境のCLI経由でyovoiceにより生成されました。「穏やか」と「嬉しい」は同一テキスト・同一声線で、感情パラメータのみを変更しています。ブラウザ上でモデルを実行しているわけではありません。
デフォルトでは、ローカルの ~/.yovoice ディレクトリに保存されます。すべての原稿、音声アセット、モデルは手元で完全に管理されます。アプリをアンインストールしてもデータが消えることはありません。PCを移行する際は、このディレクトリをそのままバックアップ・コピーできます。
ローカル音声生成と楽譜レンダリングは完全オフラインで動作します。初回インストール時、モデルや音色ライブラリのダウンロード時、およびオプションのクラウドAI機能を使用する時のみネットワークが必要です。必要なファイルが揃えば、音声や音楽の生成はすべてローカルで完結します。楽譜レンダリングに推論エンジンやGPUは不要です。
はい、オプション機能として利用可能です。DeepSeek、Qwen、Kimi、OpenAI、Anthropic、Ollamaまたは互換APIを接続することで、AIが編曲全体を作曲したり、スタイル・歌詞・タイトルを提案したりできます。利用しなくても他の機能には影響しません。APIキーはローカルにのみ保存され、リクエストは選択したプロバイダにのみ送信されます。
現在の推論エンジンは audio.cpp v0.9.3 です。デスクトップ版は以下に対応しています:
軽量な読み上げには4GB以上のメモリ、高音質クローンや音声設計には4〜6GBのVRAMまたは8GB以上のApple Silicon、楽曲や純音楽の生成には12GB以上のVRAMまたは16GB以上のApple Siliconを推奨します。必要要件は選択するモデルと精度によって異なります。
自動オーディオ診断と放送レベルのラウドネス基準エクスポートに対応:生成直後に音割れ、クリックノイズ、末尾の途切れ、過度な無音を自動検知し、タイムライン上に詳細と発生時間を表示。エクスポート時はオーディオブック(−18 LUFS)、ポッドキャスト(−16 LUFS)、動画共有サイト(−14 LUFS)の目標ラウドネスを選択でき、トゥルーピークを−1 dBTP未満に抑えます。
yovoice 自体は Apache-2.0 オープンソースライセンスを採用しています。生成物の商用利用可否は、各モデルのライセンスおよび入力素材に対する権利関係に依存します:
もちろん可能です。独立CLI、Agent Skill、MCP連携により、デスクトップアプリを起動することなく、テキストと参照音声からの音声合成や、`yovoice score render` によるミックス・ステム出力が可能です。
 yovoice DESKTOP APPLICATION
ローカル音声・音楽制作 · バージョン比較 · 自動音声診断 · 基準ラウドネス書き出し
アイコンをクリックして、AIにyovoiceのドキュメントを読み込ませ質問できます。
WeChatでQRコードをスキャンしてフォロー